 Инструмент Дня
После часового созвона с клиентом всплывает классическая проблема: договорённости есть, а протокола — нет. Кто-то должен был вести заметки, но все разговаривали. Решение простое: записать встречу и переложить расшифровку на Whisper — открытую модель распознавания речи от OpenAI, которую можно запустить у себя на компьютере. Файл не покидает вашу машину, подписка не нужна, ограничений по минутам нет.
Whisper — не единственный вариант, но именно он стал стандартом для локальной транскрибации: работает офлайн, знает русский и ещё девяносто с лишним языков, умеет ставить временны́е метки. Ниже — как выбрать модель, запустить расшифровку и превратить сырой текст в usable протокол.
Час аудио расшифровывается за 5–15 минут на обычном ноутбуке (модель small) — процессорный вариант whisperturbo не нужен, если вы не гоняете записи пачками. Проще всего начать с GUI-обёртки: Whishper или Buzz для десктопа, Whisper WebUI в браузере. Продвинутый путь — командная строка faster-whisper. Облака (OpenAI Whisper API, AssemblyAI) быстрее, но текст уходит на чужие серверы и появляется оплата за минуты.
Почему локально, а не облачный сервис
Созвоны с клиентами — это коммерчески чувствительный разговор: цены, сроки, претензии. Отправлять такую запись в облако без особой причины — лишний риск. Локальный Whisper решает три задачи сразу:
Конфиденциальность. Аудио обрабатывается на вашей машине, интернет нужен только один раз — чтобы скачать модель.
Нулевая стоимость. Ни подписок, ни оплаты за минуты расшифровки. Платите только электричеством и временем процессора.
Нет лимитов. Хоть ten встреч в день, хоть архив встреч за год — модель не спросит квоту.
Шаг 1. Выберите модель
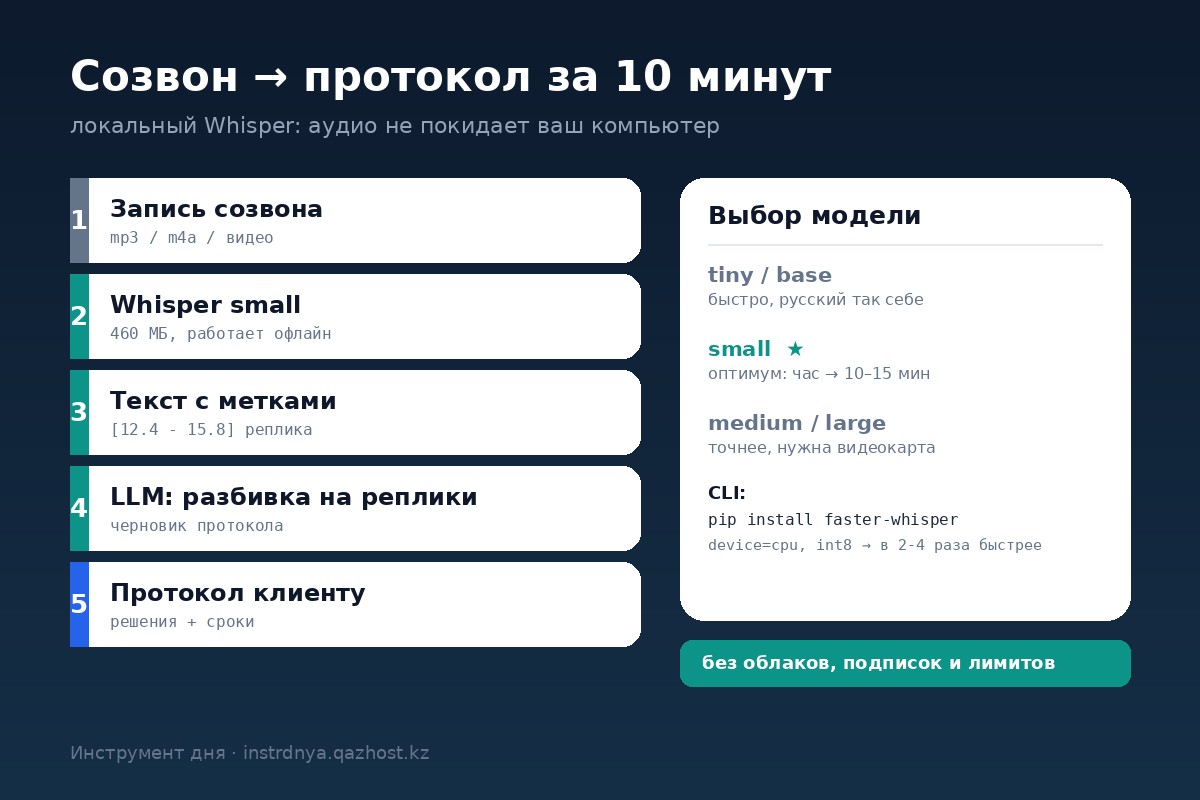
Whisper выпускается в пяти размерах, и от выбора зависит баланс «качество ↔ скорость»:
tiny и base — почти мгновенно даже на слабом железе, но русский расшифровывают с ошибками. Годятся для черновой навигации по длинной записи.
small — оптимальная рабочая модель для русского: понимает речь с акцентами, справляется с профильной лексикой умеренно. Час аудио — порядка 10–15 минут на обычном CPU.
medium и large-v3 — заметно точнее, но на процессоре час аудио может расшифровываться час и дольше. Имеют смысл при наличии дискретной видеокарты.
Практическое правило: начинайте со small. Если в тексте много грубых ошибок на привычной лексике — пробуйте medium.
Шаг 2. Запустите простым способом (GUI)
Для разовых расшифровок хватит обёртки без единой строчки кода:
Buzz (Windows/macOS/Linux) — устанавливается как обычное приложение, перетаскиваете файл, выбираете модель и язык, ждёте. Поддерживает формат SRT с временными метками.
Whishper — самостоятельный веб-интерфейс, который поднимается на своём компьютере в Docker: удобный редактор текста, очередь файлов, экспорт в TXT/SRT/JSON.
Whisper WebUI — браузерный интерфейс, часто ставится одной командой через Docker; удобно, если хотите показать процесс коллеге.
Первый запуск скачает модель (для small — около 460 МБ), дальше она живёт на диске и работает офлайн.
Шаг 3. Или командная строка (faster-whisper)
Если расшифровки идут регулярными пачками, быстрее работать из терминала. Пакет faster-whisper — оптимизированная реализация Whisper, на том же железе работает в 2–4 раза быстрее оригинала:
pip install faster-whisperМинимальный скрипт расшифровки:
from faster_whisper import WhisperModel

model = WhisperModel("small", device="cpu", compute_type="int8")
segments, info = model.transcribe("zvonok-klientu.mp3", language="ru")

with open("protokol.txt", "w", encoding="utf-8") as f:
    for seg in segments:
        f.write(f"[{seg.start:6.1f} - {seg.end:6.1f}] {seg.text}\n")
На выходе — текст с временными метками в квадратных скобках. Метки удобно оставлять: по ним потом легко найти «а вот тут он обещал прислать до пятницы» и перейти прямо к этому моменту записи.
Полезные параметры: beam_size=5 — чуть качественнее текст за небольшую дополнительную скорость; initial_prompt — подсказка модели в виде словаря проектных терминов, заметно снижает количество ошибок в названиях продуктов и аббревиатурах.
Шаг 4. Подготовьте аудио
Качество расшифровки на 80% определяется качеством записи:
Один микрофон на одного говорящего. Если все пишутся в один канал, модель смешивает реплики и путает атрибуцию. В Zoom и Google Meet записи участников разносятся по отдельным дорожкам — берите их, а не общую дорожку комнаты.
Формат не важен, качество — да. Whisper пережёвывает mp3, m4a, wav, ogg и видео целиком. Критично другое: не пережать в низкий битрейт и не сохранять с обрезанной частотой.
Шумоподавление — умеренно. Агрессивные шумодавы иногда «съедают» окончания слов и делают текст хуже. Лучше тихая комната и нормальный микрофон.
Шаг 5. Превратите текст в протокол
Сырая расшифровка — стена текста без абзацев и знаков препинания в нужных местах. Доводка занимает 10 минут, если идти по чек-листу:
1. Разбейте на реплики. Загрузите текст в LLM с запросом «разбей на реплики по спикерам, временные метки сохрани» — это черновик, который потом правится руками.
2. Выпишите решения. Просмотрите метки и выпишите: что решили, кто за что отвечает, к какому сроку.
3. Отметьте открытые вопросы. Всё, что «давай уточним» или «посмотрим» — в отдельный список, иначе потеряется.
4. Согласуйте с клиентом. Протокол уходит клиенту до следующего созвона — это и удобство, и защита от «мы такого не говорили».
Чего Whisper не умеет
Различать спикеров сам по себе. Он пишет текст, но не говорит, кто сказал. Разделение по спикерам (diarization) делается отдельными инструментами — pyannote, либо расшифровываются раздельные дорожки, записанные в Zoom/Meet.
Имена и числа проверять не может. Модель уверенно пишет «Иван» там, где было «Ильдар», и «двадцать» вместо «двухсот». Имена, суммы и даты всегда сверяйте с записью.
Тяжёлая техническая лексика. Специализированные термины без контекста модель порой искажает. Спасает initial_prompt со словарём терминов проекта.
Итог
Локальный Whisper превращает «у нас была встреча, но заметок нет» в системный процесс: запись → расшифровка за 10–15 минут → протокол с решениями и сроками. Старт с GUI-обёртки (Buzz, Whishper) занимает один вечер, переход на faster-whisper — экономит часы при регулярных расшифровках. А сам текст, в отличие от облачных сервисов, никуда с вашего компьютера не уезжает — что для рабочих созвонов скорее правило, чем приятный бонус.